Meta mostró por dentro Prometheus, su supercúmulo de IA en Ohio que apunta a cerca de un millón de GPU
La empresa detalló los racks de NVIDIA, la red entre edificios y cómo redujo 99% las interrupciones de los entrenamientos. No informó la potencia en megavatios ni la inversión.
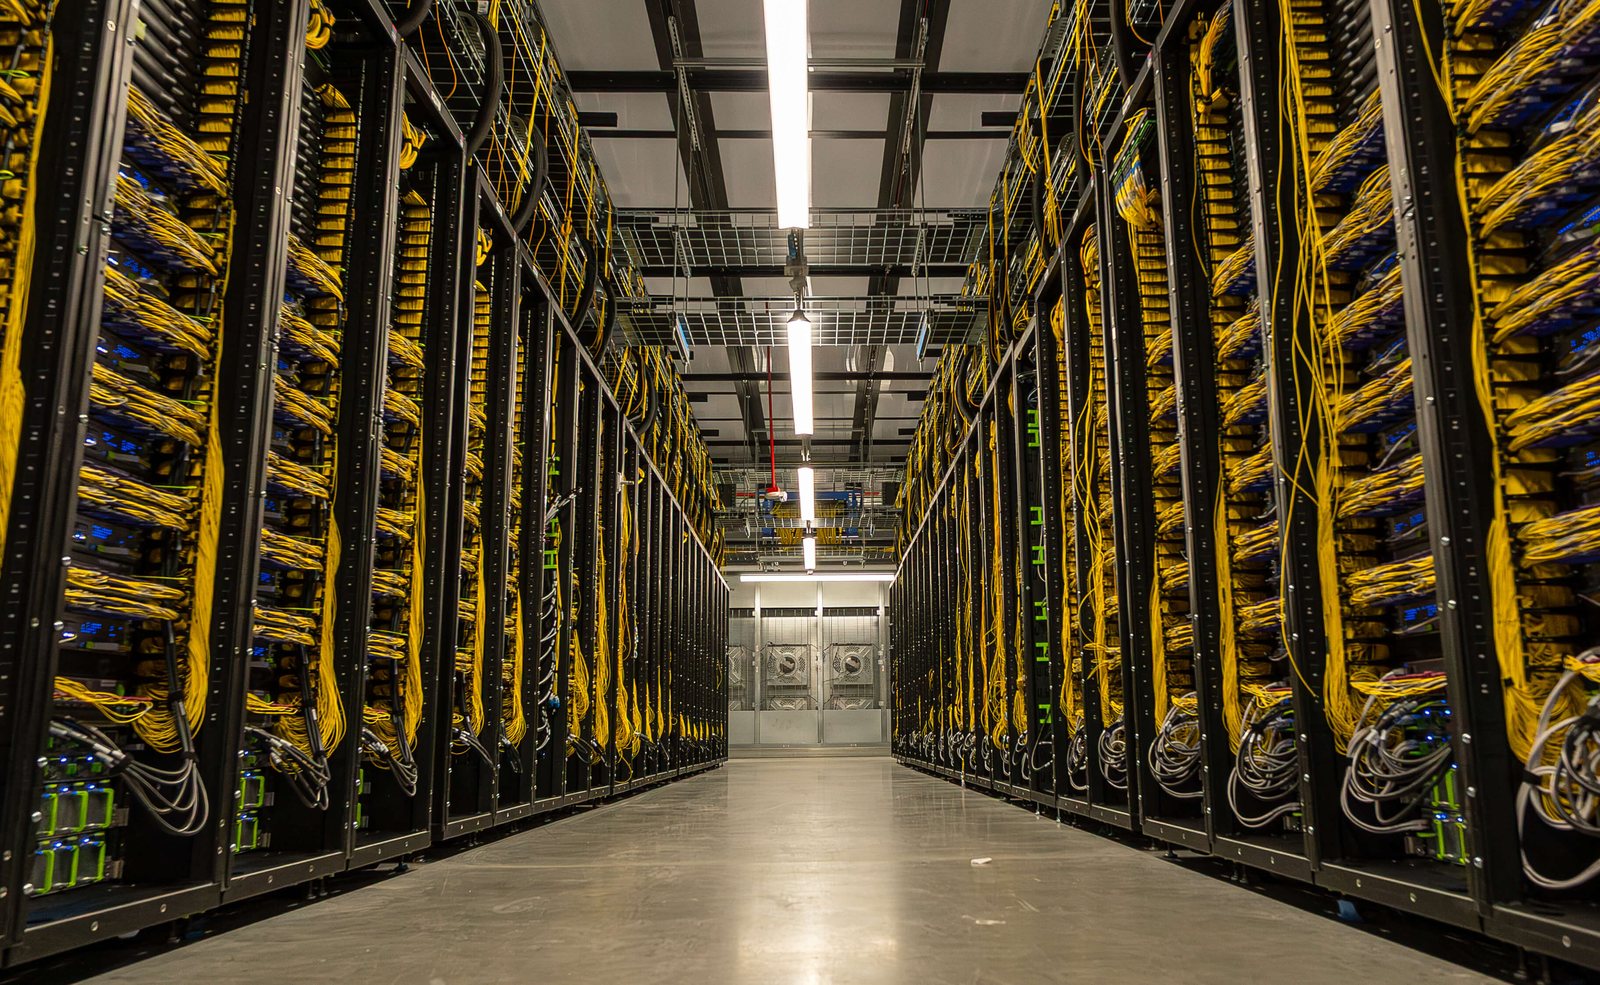
Meta publicó el lunes 19 de octubre la descripción técnica más detallada hasta ahora de Prometheus, el supercúmulo de cómputo para inteligencia artificial que construye en New Albany, Ohio, Estados Unidos. Según la empresa, la primera fase, de “escala de gigavatios”, ya está terminada y se usó para entrenar su familia de modelos Muse, incluidos los Muse Wonder; hoy reúne “cientos de miles” de GPU en varios edificios conectados entre sí, y a escala completa sumará “aproximadamente un millón” de GPU distribuidas que funcionan de manera sincronizada[1].
El artículo, firmado por los ingenieros Kevin Lee, Yashar Bayani, Ahmed Sharif y Yee Jiun Song en el blog Engineering at Meta, no da una cifra en megavatios ni la inversión total, ni una fecha de finalización[1]. Cuenta que hace dos años New Albany era un centro de datos convencional que atendía tráfico web, y que el complejo combina edificios tradicionales, edificios diseñados para IA y “estructuras de despliegue rápido”, que según Meta “redefinieron” la forma de construir[1].
Tres generaciones de racks
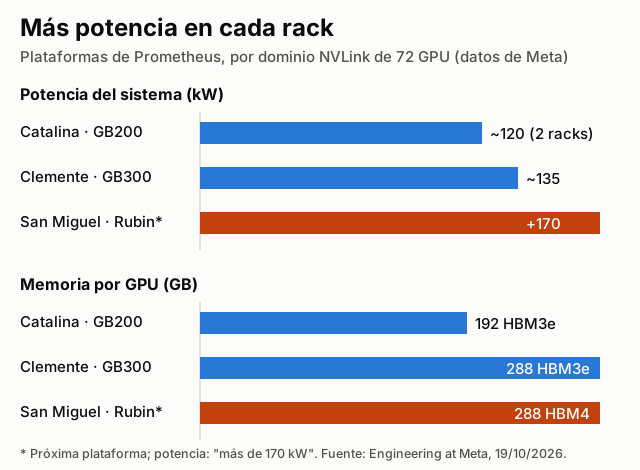
El cómputo se organiza en dominios de 72 GPU de NVIDIA conectadas por NVLink. La primera plataforma, Catalina, usa el sistema GB200 NVL72 repartido en dos racks de 36 GPU: 192 GB de memoria HBM3e por GPU, 720 petaflops de pico en precisión FP8 y unos 120 kW entre los dos racks. La segunda, Clemente, con GB300 NVL72, mete las 72 GPU en un solo rack de unos 135 kW, con 288 GB por GPU, 50% más, y un rendimiento entre 5% y 10% superior[1].
La tercera, San Miguel, se basará en Vera Rubin NVL72 y llegará “pronto”, sin fecha: 288 GB de HBM4 por GPU, 1,26 exaflops de pico en FP8 por rack, refrigeración líquida completa con más de 170 kW por rack y, según Meta, entre 10% y 20% más rendimiento por vatio que la GB300[1]. Cada GPU consume unos 1.400 W[1].
Una red propia entre edificios
Las GPU se comunican por una red Ethernet dedicada, separada de la red general del centro de datos, que Meta llama Back-End. Cada edificio tiene un tejido que conecta hasta 20.736 GPU, con conmutadores de 51,2 terabits por segundo (Minipack3 y Minipack3N, este último basado en el chip Spectrum-4 de NVIDIA) que corren el sistema operativo propio de Meta, FBOSS. Los edificios se unen por una capa de agregación construida con chasis Arista 7800 y chips Broadcom Jericho3, que cubre distancias de 2 km a más de 100 km[1]. En total, la empresa menciona millones de millas de fibra, decenas de miles de conmutadores y millones de transceptores ópticos[1].
Fallas y energía
En la etapa inicial, a mediados de 2025, las interrupciones llegaron a “casi 1.000 eventos por cada 8.000 GPU por día”, según el artículo, que informa una reducción de 99% tras un año de trabajo de ingeniería. En los entrenamientos de Muse Wonder, Meta dice haber obtenido más de 85% de tiempo útil (goodput) en el preentrenamiento y más de 90% en las corridas de aprendizaje por refuerzo. Su meta es bajar a dos interrupciones por cada 8.000 GPU por día[1].
El consumo también es un problema de ingeniería. El entrenamiento sincronizado provoca oscilaciones de carga de 30% a 40% dentro del cúmulo, y arrancar o pausar un trabajo grande puede mover “más de decenas de megavatios en segundos”. Meta las amortigua con un sistema que limita gradualmente la potencia de las GPU, baterías en cada rack, bancos de capacitores, almacenamiento en baterías a escala de la planta y coordinación con la distribuidora[1]. La refrigeración combina módulos de líquido asistido por aire en los edificios convencionales y las estructuras rápidas con refrigeración líquida de planta en el edificio diseñado para IA[1].
La empresa afirma que paga “el costo total de la energía” del sitio y que se asoció con desarrolladores para igualar su consumo con nueva energía limpia y renovable; el artículo no detalla los contratos ni las fuentes[1]. Lo aprendido, dice Meta, se aplica a Hyperion, su próximo supercúmulo, en Richland Parish, Luisiana, con refrigeración líquida de circuito cerrado y conexión a la red de Entergy[1].
Multimedia y documentos
- Ubicación
- New Albany, Ohio (EE.UU.)
- Escala
- “Gigavatios”; la empresa no da la cifra en MW
- GPU
- Cientos de miles hoy; ~1 millón a escala completa
- Tejido por edificio
- Hasta 20.736 GPU
- Consumo por GPU
- ~1.400 W
- Interrupciones
- −99% desde el pico de mediados de 2025
- Tiempo útil (Muse Wonder)
- Más de 85% en preentrenamiento; más de 90% en aprendizaje por refuerzo
Fuentes
- Meta (Engineering at Meta). Kevin Lee, Yashar Bayani, Ahmed Sharif y Yee Jiun Song. «Inside Prometheus: Meta's Journey to a Gigawatt-Scale Supercluster». 19 oct. 2026. engineering.fb.com