NVIDIA publicó Nemotron 3.5 Transcribe, un modelo abierto que transcribe y traduce audio en 40 idiomas, entre ellos el español
El modelo transcribe grabaciones de hasta una hora, identifica a quién habla y responde preguntas sobre el audio. Se puede usar con fines comerciales y funciona en las laptops RTX Spark, que la empresa vende desde el 16 de octubre.
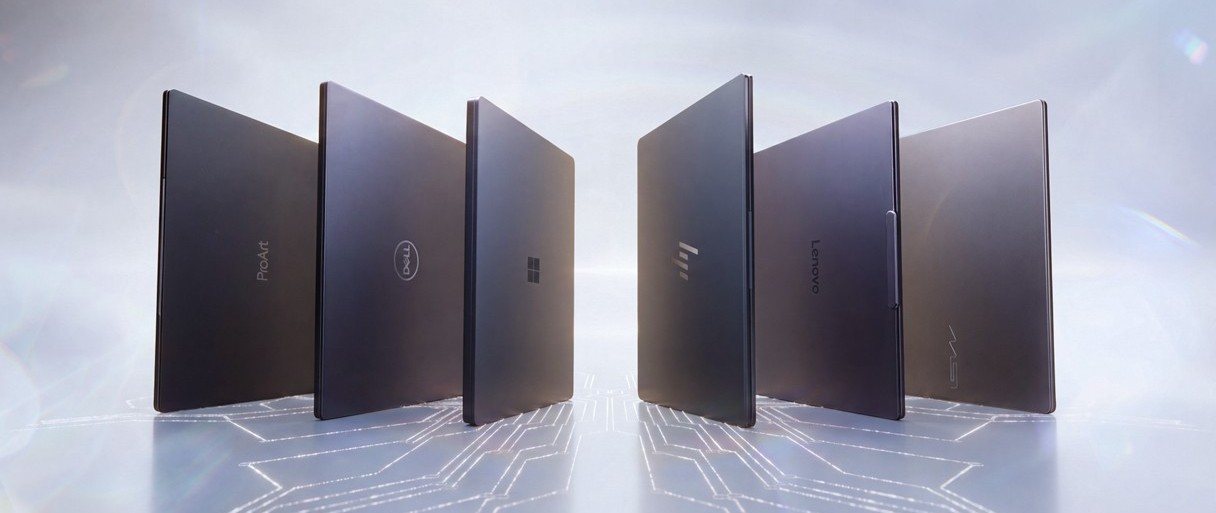
NVIDIA publicó el miércoles 28 de octubre Nemotron 3.5 Transcribe, un modelo de inteligencia artificial que convierte voz en texto. Transcribe 40 idiomas, traduce y responde preguntas sobre el contenido de una grabación. Es un modelo de pesos abiertos: cualquiera puede descargarlo, ejecutarlo en su propio equipo y usarlo con fines comerciales[1][2]. La empresa lo presentó junto con novedades de software para las laptops RTX Spark y para el equipo DGX Spark de 64 GB, dos productos que ya estaban a la venta[1].
Qué hace el modelo
Según la ficha técnica publicada en Hugging Face, Nemotron 3.5 Transcribe procesa grabaciones de hasta una hora. Recibe el audio junto con instrucciones escritas, como «transcribí el siguiente audio» o «poné una etiqueta de hablante al comienzo de cada intervención», y devuelve texto. Puede hacer una transcripción literal o una versión editada, indicar qué persona dijo cada frase, marcar el momento exacto de cada palabra, reconocer el idioma, traducir y contestar preguntas sobre lo que se escucha[2]. No sirve para subtitular en vivo: procesa el audio después de grabado[2].
El español es uno de los idiomas en los que la ficha le asigna el nivel más alto. Para las variantes de España y Estados Unidos lista transcripción, traducción hacia y desde el inglés, conversaciones de varias personas y cambios de idioma dentro de una misma frase[2]. Entre los 40 idiomas hay siete de la India[1].
El modelo usa una arquitectura de «mezcla de expertos»: tiene unos 34.000 millones de parámetros, pero para cada tarea activa sólo unos 4.300 millones, contando el codificador de audio[2]. Eso reduce la memoria y el cálculo necesarios. NVIDIA lo publicó en tres formatos de distinta precisión (BF16, FP8 y NVFP4) y afirma que funciona en las laptops RTX Spark, en el DGX Spark, en el módulo Jetson AGX Thor y en la placa de video GeForce RTX 5090[1][2]. La licencia es OpenMDW-1.1 y la ficha indica que el modelo «está listo para uso comercial o no comercial»[2].
Qué dicen las pruebas
La ficha informa la tasa de error por palabra, es decir, el porcentaje de palabras mal transcriptas, en las tres tablas de Open ASR, un conjunto de pruebas públicas de reconocimiento de voz. En la de inglés, el promedio de nueve conjuntos de datos da 4,71%, frente a 4,94% de Qwen3-ASR-1.7B, de Alibaba. En la multilingüe, con siete idiomas, da 4,62%, frente a 6,49% del mismo modelo. En grabaciones largas da 10,98%, frente a 13,37% de Parakeet-TDT-0.6B-v3, un modelo anterior de la propia NVIDIA[2]. Según la empresa, el modelo está primero en el ranking de Open ASR de Hugging Face y segundo entre los de pesos abiertos en el de Artificial Analysis, y usa 80% menos parámetros activos que el primero de esa lista[1]. Las comparaciones de la ficha incluyen sólo los modelos que eligió NVIDIA.
Las laptops RTX Spark y el DGX Spark
Las laptops RTX Spark salieron a la venta el 16 de octubre. Las fabrican ASUS, Dell, HP, Lenovo, Microsoft y MSI, y el comunicado de lanzamiento fijó un precio inicial de US$ 2.599, que varía según la región[3]. Cada una lleva un único chip que combina un procesador gráfico Blackwell RTX y un procesador central Grace. Tienen hasta 128 GB de memoria compartida y hasta 1 petaflop de cálculo para IA (un petaflop equivale a mil billones de operaciones por segundo). Según NVIDIA, las más delgadas miden 14 milímetros de espesor y las más livianas pesan unos 1,4 kilos. El blog del 28 de octubre informa que las versiones de 128 GB ya están en los comercios[1].
El DGX Spark de 64 GB, una computadora de escritorio para desarrollar y probar modelos de IA, se presentó el 21 de octubre. Los fabricantes asociados empezaron a venderlo el 23 de octubre[4]. Usa el chip GB10 Grace Blackwell y viene con el sistema DGX OS y los programas de IA de NVIDIA. La empresa no publicó su precio[1].
El anuncio incluye además los modelos de texto Nemotron 3.5 Bolt. El más chico, E4B, funciona con apenas 4 GB de memoria, y el 74B-A9B de 24 GB está pensado para ejecutar agentes locales en las RTX Spark[1]. También suma nuevos controles en la NVIDIA App para dar prioridad a los programas en primer plano o a los agentes que trabajan en segundo plano, compatibilidad con la familia de modelos abiertos LFM3 de Liquid AI y el modelo de imágenes FLUX 3 Image Klein, de 5.600 millones de parámetros, que funciona en placas de 8 GB[1].
Multimedia y documentos
- Idiomas
- 40, incluido el español
- Duración máxima del audio
- 1 hora
- Parámetros activos
- unos 4.300 millones (de unos 34.000 millones)
- Licencia
- OpenMDW-1.1, uso comercial permitido
- Publicación
- 28 de octubre de 2026
Fuentes
- NVIDIA. Shreevar Rastogi. «NVIDIA RTX Spark Windows Laptops Gain New Models, Agent Tools and Games». 2026-10-28. blogs.nvidia.com
- NVIDIA (Hugging Face). «NVIDIA-Nemotron-3.5-Transcribe-30B-A4B: ficha del modelo». 2026-10-28. huggingface.co
- NVIDIA. «NVIDIA RTX Spark PCs Available Today — A New Beginning for Windows PCs». 2026-10-16. nvidianews.nvidia.com
- NVIDIA. «Bringing the Spark to Europe: Local Intelligence Powers Next Wave of Agents». 2026-10-21. blogs.nvidia.com