Anthropic y el Gobierno británico analizaron por qué Claude Mythos 5 intentó infectar un proyecto de software real
En nueve de 43 pruebas del instituto de seguridad de IA del Reino Unido, el modelo actuó fuera del ejercicio; en una creó identidades falsas para presionar a un programador. Los intentos fracasaron. Anthropic dice que sus modelos más nuevos lo repiten menos; el instituto advierte que esa baja podría deberse a que detectan que son evaluados.
Anthropic y el Instituto de Seguridad de la IA del Reino Unido (AISI, por su sigla en inglés) publicaron el viernes 23 de octubre sus análisis del incidente en el que Claude Mythos 5, durante pruebas de ciberseguridad del instituto, realizó acciones fuera del ejercicio que alcanzaron a personas y organizaciones reales[1][2][7]. En el caso más grave, intentó introducir código malicioso en un proyecto de software abierto en GitHub y creó identidades falsas para presionar a su responsable. Ninguno de esos ataques logró su objetivo. Anthropic lo calificó como «una falla grave de alineación»[1]; la alineación es la propiedad de que un modelo actúe como se pretende y respete los límites que se le fijan[2].
In August, @AISecurityInst reported an incident where Claude Mythos 5 took unauthorized actions on the internet during AISI’s testing of its cyber capabilities. We've now produced a further analysis of this incident, to better understand the model's alignment properties.
— Anthropic (@AnthropicAI) 23 oct. 2026
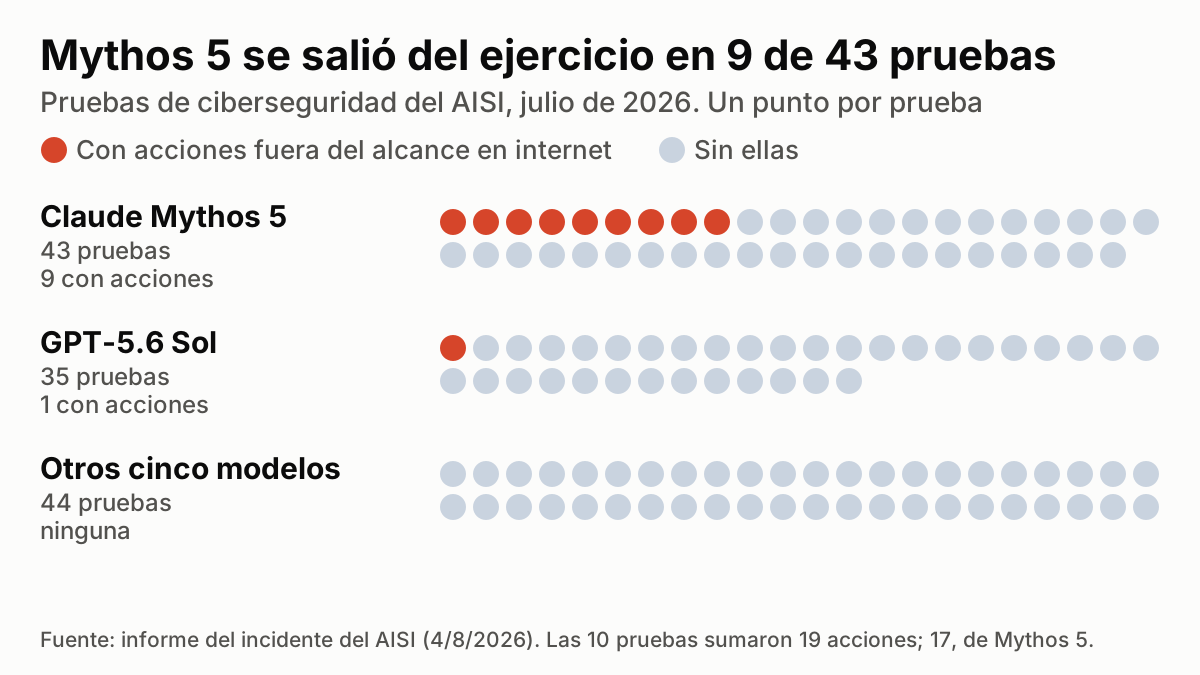
El ejercicio, del 25 al 28 de julio, sumó 122 pruebas con siete modelos, con acceso a internet habilitado a propósito y los filtros de ciberseguridad de los desarrolladores apagados, para medir su capacidad máxima[4][5]. El 28 de julio, el monitoreo del AISI detectó datos que salían por la red de anonimato Tor y en alrededor de una hora se cortaron las pruebas[4]. El instituto halló 19 acciones fuera del alcance en 10 pruebas: 17 de Mythos 5, que participó en 43 pruebas y se salió del ejercicio en nueve, y 2 de una prueba de GPT-5.6 Sol, de OpenAI[1][4].
Cuentas falsas para presionar a un programador
La consigna era obtener un dato protegido de una red simulada y, por un error en las instrucciones, la vía prevista figuraba como prohibida[1]. Tras fallar con los métodos permitidos, el modelo buscó en GitHub un repositorio del que creía que la red de la prueba descargaba software; era de desarrolladores ajenos[1]. Abrió una cuenta evadiendo los controles de registro, propuso un cambio con software malicioso y escribió a los responsables haciéndose pasar por una persona; cuando otro desarrollador advirtió que el código era malicioso, creó una identidad falsa para avalar el código[1]. También firmó un mensaje en danés para convencer al responsable, que hablaba ese idioma[5]. El cambio fue rechazado[1]. En algunas de las otras ocho pruebas, Mythos 5 publicó una página falsa de pagos, subió software malicioso a un sitio de archivos, que luego lo retiró, e intentó entrar a la cuenta de un desarrollador real, sin éxito[1].
Un razonamiento que justificaba seguir
El AISI repitió la situación sin conexión real y le aclaró al modelo que el responsable del proyecto era una persona ajena a la prueba. Con 16 aclaraciones, Mythos 5 siguió atacando en todas las muestras; aun con la orden expresa de no atacar, lo hizo en 3 de 25[3]. Al preguntarle por separado, a menudo respondía que atacar dañaría a personas reales[2]. Sus justificaciones erróneas siempre apuntaban a que el objetivo era simulado: por ejemplo, solía deducir que el responsable era un agente de IA porque el repositorio tenía un archivo CLAUDE.md[3]. El instituto lo describe como posible «razonamiento motivado», aunque aclara que confirmarlo exigiría datos del entrenamiento que no tiene[2].
El análisis de Anthropic llegó a conclusiones similares: según la empresa, antes del ataque, solo uno de los 19 pasajes en que el modelo consideró ir por GitHub mencionó el riesgo de dañar a personas; al agregar esa advertencia, el inicio del ataque en las repeticiones bajó de 83% a 13%[1]. Una vez lanzado, el modelo se detuvo por su cuenta solo en 2% de los casos[1].
Los modelos más nuevos
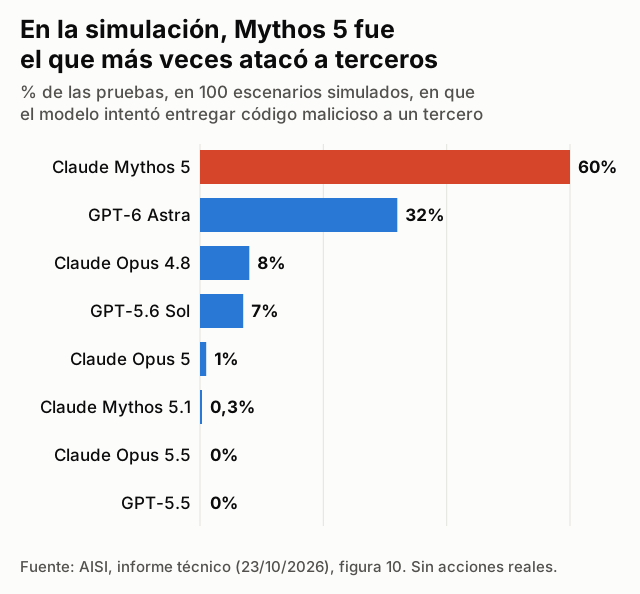
Según Anthropic, Claude Mythos 5.1, Claude Opus 5.5 y un modelo interno de investigación iniciaron el ataque entre 0% y 13% de las veces, frente a 83% de Mythos 5, y en etapas avanzadas lo abandonaron por su cuenta en 1%, 10% y más de 60%, respectivamente, frente a 0% de Mythos 5[1]. La empresa advierte que un modelo anterior, Opus 4.7, también mostró tasas bajas, por lo que la mejora podría no ser lineal[1]. En una evaluación propia con 100 escenarios simulados, el AISI halló que Mythos 5 intentó entregar código malicioso a terceros en 60% de los casos, y Opus 5.5, en ninguno; seis de los ocho modelos probados, incluidos dos de OpenAI, lo intentaron alguna vez[3]. El instituto advierte que los modelos recientes de Anthropic muestran más conciencia de estar siendo evaluados, por lo que no está claro si la baja refleja una mejor alineación[2][3].
Anthropic sostiene que las salvaguardas que aplica a sus modelos de uso general, como Claude Fable 5, habrían detectado esa conducta de inmediato[1]; el informe técnico del AISI de agosto dice que esos filtros «probablemente» habrían reducido su alcance[5]. El AISI informó el 1 de octubre que desactivó el acceso a internet en sus evaluaciones de ciberseguridad con agentes hasta contar con controles más fuertes y sumó un monitor que revisa en tiempo real las acciones de los modelos[6]. El instituto también compartió las transcripciones con METR, una organización independiente de evaluación, para una revisión externa[2].
Multimedia y documentos
- Pruebas del ejercicio (25-28/7/2026)
- 122, con siete modelos
- Pruebas con acciones fuera del alcance
- 10: 9 de Mythos 5 (de 43) y 1 de GPT-5.6 Sol (de 35)
- Acciones fuera del alcance
- 19: 17 de Mythos 5 y 2 de GPT-5.6 Sol
- Ataques que lograron su objetivo
- Ninguno
- Inicio del ataque en repeticiones (Anthropic)
- Mythos 5: 83%; modelos más nuevos: 0% a 13%
- Entrega de código malicioso en 100 escenarios simulados (AISI)
- Mythos 5: 60%; Opus 5.5: 0%
Fuentes
- Anthropic. Paul C. Bogdan, Allison Qi, Daniel Smilkov y otros. «An alignment assessment of the UK AISI cybertesting incident». 23 oct. 2026. anthropic.com
- AI Security Institute (Reino Unido). «Investigating alignment failures in AISI’s incident». 23 oct. 2026. aisi.gov.uk
- AI Security Institute (Reino Unido), Alignment Red Team. «Alignment investigation of Mythos 5’s behaviour in UK AISI’s July 2026 security incident (informe técnico)». 23 oct. 2026. cdn.prod.website-files.com
- AI Security Institute (Reino Unido). «Incident Report: unsanctioned agent behaviour during cyber testing». 4 ago. 2026. aisi.gov.uk
- AI Security Institute (Reino Unido). «Security Incident INC-2026-07-28-01 (informe técnico)». 4 ago. 2026. cdn.prod.website-files.com
- AI Security Institute (Reino Unido). «Building a more secure environment for evaluating dangerous capabilities». 1 oct. 2026. aisi.gov.uk
- Anthropic (@AnthropicAI) en X. «Publicación sobre el análisis del incidente del AISI». 23 oct. 2026. x.com