Google y Microsoft adoptarán una señal común en robots.txt para que los sitios rechacen el entrenamiento de IA
Con una sola línea, un sitio podrá pedir que su contenido no se use para entrenar modelos generativos de varias empresas a la vez. Microsoft la aplicará desde febrero de 2027 y Google, en 2027; todavía es un borrador, no un estándar.
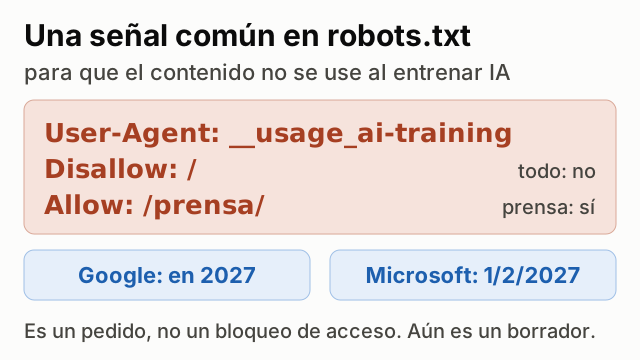
Google y Microsoft anunciaron el viernes 30 de octubre que respetarán una misma señal, escrita en el archivo robots.txt de cada sitio web, para que sus dueños pidan que su contenido no se use para entrenar modelos de inteligencia artificial generativa[1][2]. Hasta ahora, quien quería excluir su sitio debía escribir una regla aparte para el robot de cada empresa; con la nueva señal alcanza con un solo bloque para todas las empresas que la adopten[1].
El robots.txt es el archivo con el que cada sitio indica a los programas que recorren la web qué partes pueden visitar. Sus reglas quedaron fijadas en 2022 en el RFC 9309, el documento técnico del Grupo de Trabajo de Ingeniería de Internet (IETF) que describe el protocolo[5].
Cómo se usa
La señal es un nombre ficticio de robot, __usage_ai-training, una «marca de uso» según el borrador técnico. El sitio lo pone en una línea User-Agent y debajo indica qué carpetas no quiere ceder para entrenamiento (Disallow) y cuáles sí (Allow). Con Disallow: / pide que no se use nada; también puede exceptuar una carpeta, por ejemplo la de prensa. Si el archivo no menciona la marca, no expresó ninguna preferencia, y las reglas generales para todos los robots (User-Agent: *) no cuentan como respuesta[3].
El documento toma la definición de «entrenamiento de IA» del grupo de trabajo AIPREF del IETF: usar un contenido para modificar los parámetros aprendidos de un modelo generativo (uno que produce textos, imágenes u otro contenido); no incluye los modelos usados sólo para clasificar u ordenar resultados[3].
Qué hará cada empresa
Google tratará a un sitio que use la marca para rechazar el entrenamiento, y que no mencione en particular a Google-Extended, como si hubiera bloqueado Google-Extended, el control para entrenamiento de IA que ofrece desde 2023. Sus reglas propias seguirán vigentes, y los sitios que autoricen expresamente a Google-Extended podrán aparecer en las respuestas de la aplicación Gemini y recibir visitas desde ellas. La empresa dice que apunta a aplicarla en 2027, junto con otras empresas de IA[1].
Microsoft la respetará desde el 1 de febrero de 2027, a medida que sus robots vuelvan a recorrer cada sitio. También permitirá fijarla en una página concreta, por encima de lo que diga el robots.txt, y suma una preferencia aparte, sólo por página, para decidir si el contenido puede alimentar las respuestas de Bing, Copilot y Microsoft 365. Las nuevas opciones reemplazarán a NoArchive y NoCache, que la empresa dejará de leer como preferencia, ni para entrenamiento ni para esas respuestas, después del 1 de marzo de 2027[2].
Lo que la señal no hace
No impide que los robots entren al sitio. El borrador aclara que la marca «no es una directiva de rastreo»: expresa una preferencia sobre el uso del contenido, independiente de los permisos de acceso, y quien quiera limitar las visitas debe seguir usando las reglas para cada robot. También admite que un acuerdo privado entre un sitio y una empresa deje de lado la preferencia publicada[3]. Microsoft agrega que la preferencia regula el uso, no el acceso, que no cambia la presencia del sitio en los resultados comunes de Bing, que rige para el entrenamiento de modelos futuros y que no crea licencias ni pagos; si un sitio no publica nada, la regla por defecto es permitir[2].
Todavía no es un estándar. Google dice que la propuesta responde a pedidos de editores, organizaciones civiles y reguladores, y que seguirá trabajando en el IETF para convertirla en norma[1]. Por ahora es un borrador individual de Internet presentado el 30 de octubre por Kevin Kelley, de Anthropic, y la propia página del IETF advierte que «no está respaldado por el IETF y no tiene estatus formal» en su proceso de normas. Vence el 3 de mayo de 2027 si no se actualiza[3]. La guía de Anthropic para dueños de sitios, con fecha del 7 de abril, todavía indica bloquear a su robot ClaudeBot para quedar fuera del entrenamiento[4].
Fuentes
- Google Search Central. John Mueller. «Supporting a shared AI training control for websites». 2026-10-30. developers.google.com
- Microsoft Bing Blog. Krishna Madhavan. «Your content, your choice: clearer preferences for training and grounding». 2026-10-30. blogs.bing.com
- IETF Datatracker. Kevin Kelley (Anthropic). «Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)». 2026-10-30. datatracker.ietf.org
- Anthropic Privacy Center. «Does Anthropic crawl data from the web, and how can site owners block the crawler?». 2026-04-07. privacy.claude.com
- RFC Editor. M. Koster, G. Illyes, H. Zeller, L. Sassman. «RFC 9309: Robots Exclusion Protocol». 2022-09. rfc-editor.org