La china Moonshot lanzó Kimi K3.1 Pro, que liberará para descarga y que un ranking independiente ubica cuarto entre 215
La empresa publicará los pesos antes del 4 de noviembre para que cualquiera pueda descargarlo. Dice que le quitó datos de ciberseguridad para no superar a los modelos cerrados en capacidad ofensiva; según sus propias tablas, quedó detrás de ellos y de otro modelo chino abierto.
La empresa china Moonshot AI lanzó Kimi K3.1 Pro, un modelo de inteligencia artificial que una medición independiente ubicó cuarto entre 215, detrás solo de dos modelos de Anthropic y uno de Meta, y cuyos pesos —el archivo completo que permite a cualquiera descargarlo y ejecutarlo en sus propios equipos— la compañía se comprometió a publicar antes del 4 de noviembre. El modelo ya está disponible en el sitio Kimi.com, en las aplicaciones de la empresa y en su servicio para programadores, informó Moonshot en un artículo técnico fechado el 24 de octubre[1].
K3.1 Pro es una versión reentrenada de Kimi K3, el modelo de 2,8 billones de parámetros (2,8 trillion, en inglés) que la empresa presentó el 16 de julio como el primer modelo abierto de esa escala[1][4]. Para la nueva versión, Moonshot dice que usó mucho más cómputo en la etapa de aprendizaje por refuerzo, en la que el modelo practica tareas y recibe una señal de acierto o error, en cientos de áreas a la vez[1]. Admite textos de hasta un millón de tokens (unidades de unas pocas letras) y se ofrece además en una versión rápida, K3.1 Pro Highspeed, que según la empresa responde dos a tres veces más rápido[1].
Qué dice la medición independiente
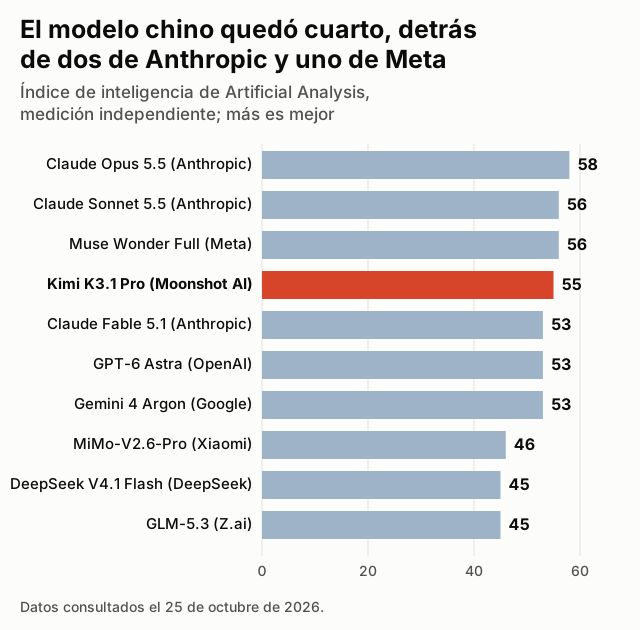
Artificial Analysis, una firma que evalúa modelos con sus propias pruebas, le asignó 55 puntos en su índice de inteligencia, el cuarto puesto entre 215 modelos, muy por encima de la mediana de 27 de los modelos de precio similar[3]. Solo lo superan tres modelos cerrados: Claude Opus 5.5, con 58, y Claude Sonnet 5.5, con 56, ambos de Anthropic, y Muse Wonder Full, de Meta, con 56[5]. Detrás quedan Claude Fable 5.1, de Anthropic, GPT-6 Astra, de OpenAI, y Gemini 4 Argon, de Google, con 53 cada uno[3]. Entre los modelos con pesos abiertos, el mejor ubicado en esa tabla es hoy MiMo-V2.6-Pro, de Xiaomi, con 46 puntos[5].
La misma medición marca sus puntos débiles: genera 57,7 tokens por segundo, el puesto 142 entre 186 modelos, y usó 150 millones de tokens para completar las pruebas del índice, contra una mediana de 87 millones; es decir, es lento y extenso en sus respuestas[3]. Artificial Analysis aún lo clasifica como modelo propietario, porque los pesos todavía no se publicaron[3].
Los precios en la plataforma de la empresa son de US$ 2 por millón de tokens de entrada y US$ 10 por millón de salida, un tercio menos que los de K3 (US$ 3 y US$ 15); la versión rápida cuesta el doble que K3.1 Pro[2].
Lo que muestran las propias tablas de Moonshot
Moonshot destacó que K3.1 Pro obtuvo 65,7% en Terminal-Bench 4.0, que mide agentes de programación en tareas de terminal, por delante de GPT-6 Astra (58,2%) y apenas detrás de Claude Opus 5.5 (66,4%)[1]. Las mismas tablas lo muestran lejos de los líderes en otras pruebas: 39,4 en HLE-Diamond, un examen de preguntas difíciles de distintas disciplinas, contra 65,8 de GPT-6 Astra, y 31,5 en ProgramBench, contra 65,0 de Claude Opus 5.5[1]. Varias de las pruebas que publica son internas de la empresa y no se pueden repetir desde afuera[1].
El límite en ciberseguridad
Moonshot dijo que la capacidad del modelo para encontrar y explotar fallas de software crecía a medida que entrenaba más y que, para la versión abierta, quitó de los datos de entrenamiento el material vinculado con ciberseguridad[1]. Según la empresa, en su prueba interna de explotación de vulnerabilidades reales el modelo sin esos recortes resolvía 90,5% de las tareas y el definitivo, 81,0%[1]. El argumento de Moonshot es que no quiere publicar pesos abiertos que amplíen el máximo de capacidad ofensiva disponible y que K3.1 Pro sigue detrás de los modelos cerrados más avanzados[1].
Sus propias tablas respaldan esa afirmación: en ExploitBench obtiene 74,7, contra 100 de GPT-6 Astra y 91,0 de Claude Opus 5.5, y en la prueba interna DeepSeek V4.1 Flash, otro modelo chino con pesos ya publicados, obtuvo 85,7%, más que K3.1 Pro[1]. Es decir que, según esos datos, la versión abierta de Moonshot no supera la capacidad ofensiva que ya está al alcance de cualquiera[1].
Multimedia y documentos
- Contexto máximo
- 1 millón de tokens
- Precio (entrada / salida)
- US$ 2 / US$ 10 por millón de tokens
- Índice de Artificial Analysis
- 55 puntos, 4.º entre 215 modelos (25/10/2026)
- Pesos abiertos
- antes del 4 de noviembre de 2026
Fuentes
- Moonshot AI (Kimi). «Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence». 24 oct. 2026. kimi.com
- Kimi API Platform (Moonshot AI). «Pricing: chat models». consultado el 25 oct. 2026. platform.kimi.ai
- Artificial Analysis. «Kimi K3.1 Pro - Intelligence, Performance & Price Analysis». consultado el 25 oct. 2026. artificialanalysis.ai
- Moonshot AI (Kimi). «Kimi K3: Open Frontier Intelligence». 16 jul. 2026. kimi.com
- Artificial Analysis. «LLM Leaderboard - Comparison of over 100 AI models». consultado el 25 oct. 2026. artificialanalysis.ai